LU Decomposition
Basics
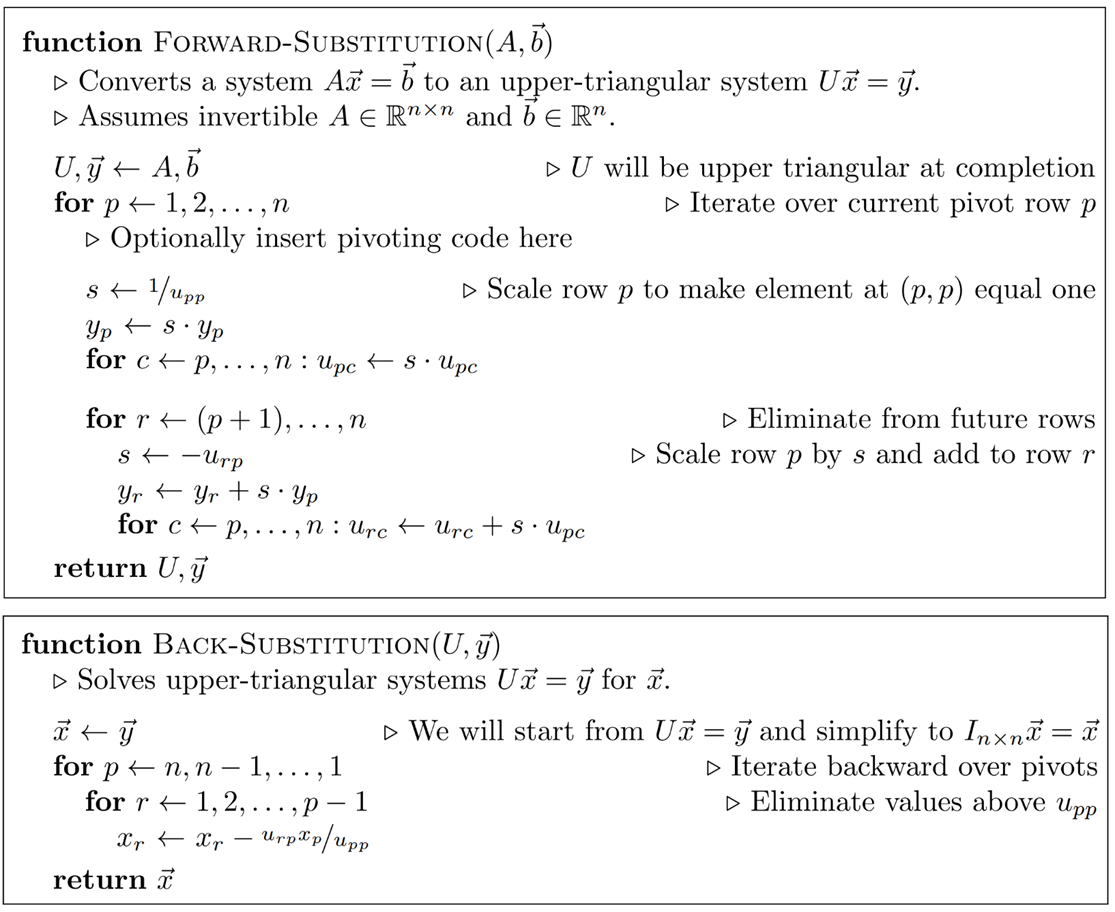
标准 LU 分解就是不带行交换的高斯消元的矩阵语言。
- Full permutation: 是一个行向量依次为 的矩阵。
- Full row scalling:
- Elimination: 将 倍第 列加到第 列。
可逆矩阵 存在标准 LU 分解的充要条件是,前 个顺序主子式均不为零
不可逆矩阵
Example: Regression of multiple experiments
Any linear system:
- vector
- polynomial
- general
相对于已经存在的采样(线性)系统而言,新增一条采样可以是冗余采样、矛盾采样、有效采样。
- 采样系统有三种可叠加信息:矛盾采样条数(是否一致)、冗余采样条数(是否冗余)、有效采样条数(是否完备)。
- 当且仅当一个采样系统一致且完备时,可以重构出唯一的原信息系统
次采样( 为方阵):
多余 次采样( 为 Thin 矩阵):
- 列满秩时:取其中 条采样构成一个无矛盾无冗余的完备采样系统,考虑新增剩下的 条采样,它们不可能是有效采样。
- 全是冗余采样时有唯一解。
- 存在矛盾采样时无解,我们退而求其次寻找最优近似解 ,即超定最小二乘问题,这等价于求解恰定问题
少于 次采样( 为 Fat 矩阵):
- 对应不完备采样系统
- 存在矛盾采样时无解,同样可以求最优近似解
- 全是冗余采样时有无数解,此时可以限定求解最小范数解
方程角度:
- 一个方程对应一个限制,一共 个限制:独立的方程对解空间施加一个维度的限制(解空间 中的一个超平面),冗余的方程不影响解的数量和自由度,矛盾的方程导致无解。
- 超平面的平移不影响解的数量和自由度,所以可以不看 只看
线性变换角度:
- 超定方程无解的情况对应 使一些维度被压平但是 在这些维度非零,欠定方程无解的情况类似,但是 的列空间本来就是目标空间的一个子空间,矛盾的出现相当于让 的列空间维度与目标空间维度之差进一步增加了。
Regularization of under-determined system
Tikhonov regularization、ridge regression、guassian prior:
越小,poor conditioned 的可能性越大; 越大,近似解的误差越大
Lasso、Laplace prior:使用 1-范数
Elastic Net:同时使用 1-范数和 2-范数
Example: Image Alignment
Gram 矩阵和 Cholesky Factorization
对称、半正定
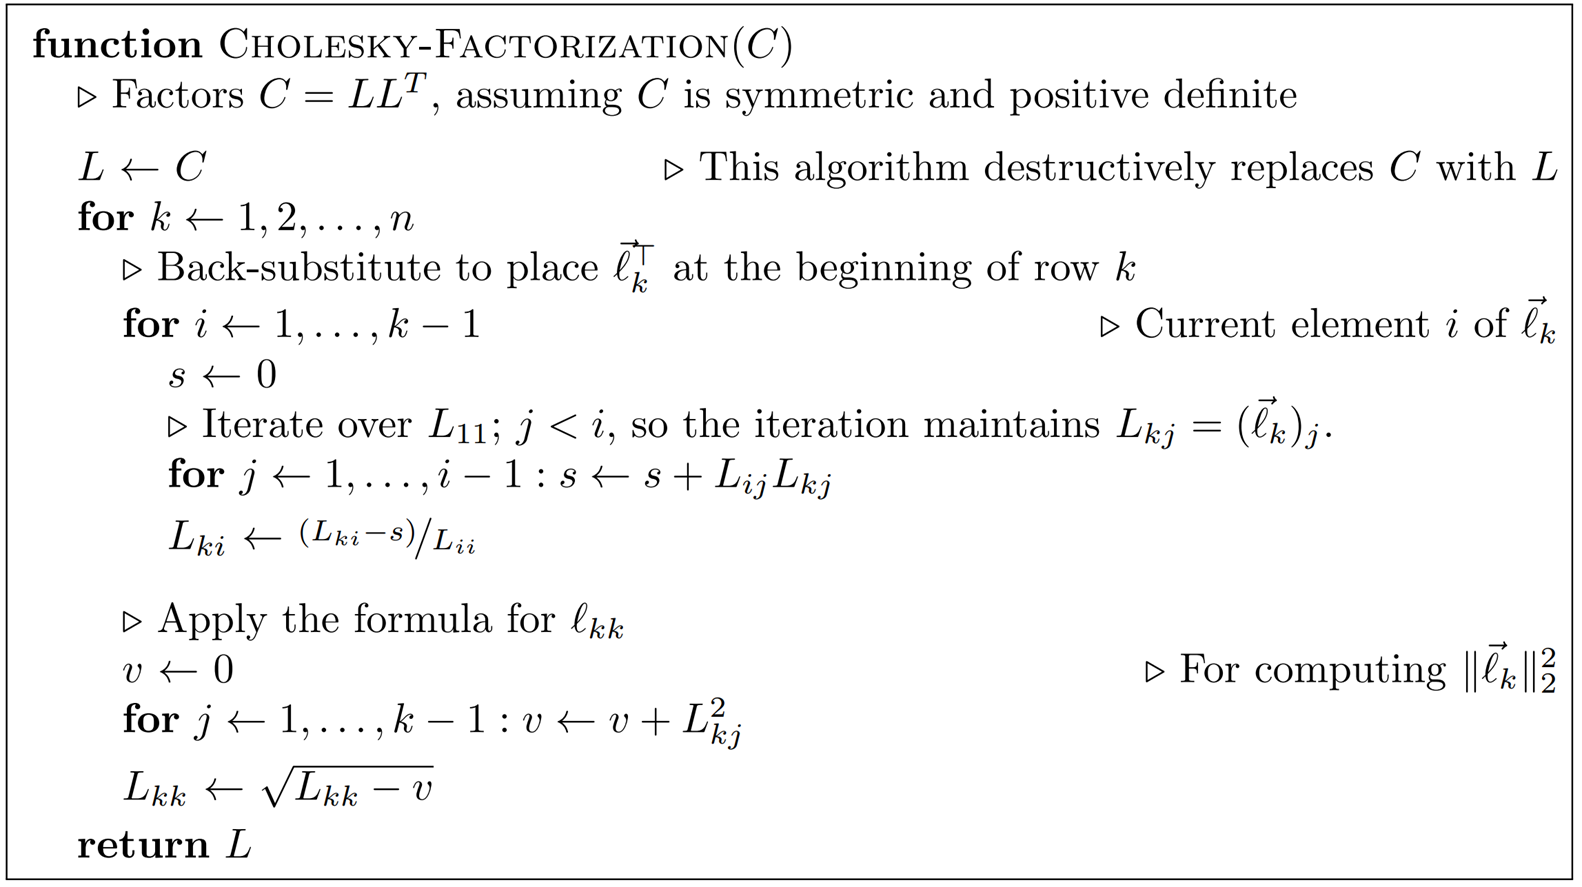
对于正定对阵矩阵 ,其 LU 分解可以具有更加简洁的形式:
half storage required
衡量向量和矩阵的大小、距离
向量 p-范数和矩阵 Frobenius 范数
矩阵诱导范数
诱导 1-范数
诱导 infty-范数
诱导 2-范数、谱范数
限制为可逆方阵 ,考虑 的一个扰动 满足 也即 ,根据诱导 2-范数的性质我们有 ,结合 得到
求解 Overdetermined
QR
求解 时 分解并不好用,条件数被平方,用 分解
当 列满秩时 一定是可逆矩阵,我们有 ,非列满秩时 一定不可逆
投影
考虑标准内积 , 向 投影,投影向量 满足
向量到向量的投影推广到向量(一维空间)到高维空间的投影:考虑空间 一组标准正交基 , 在分量 上的投影向量
Gram-Schmidt 正交化
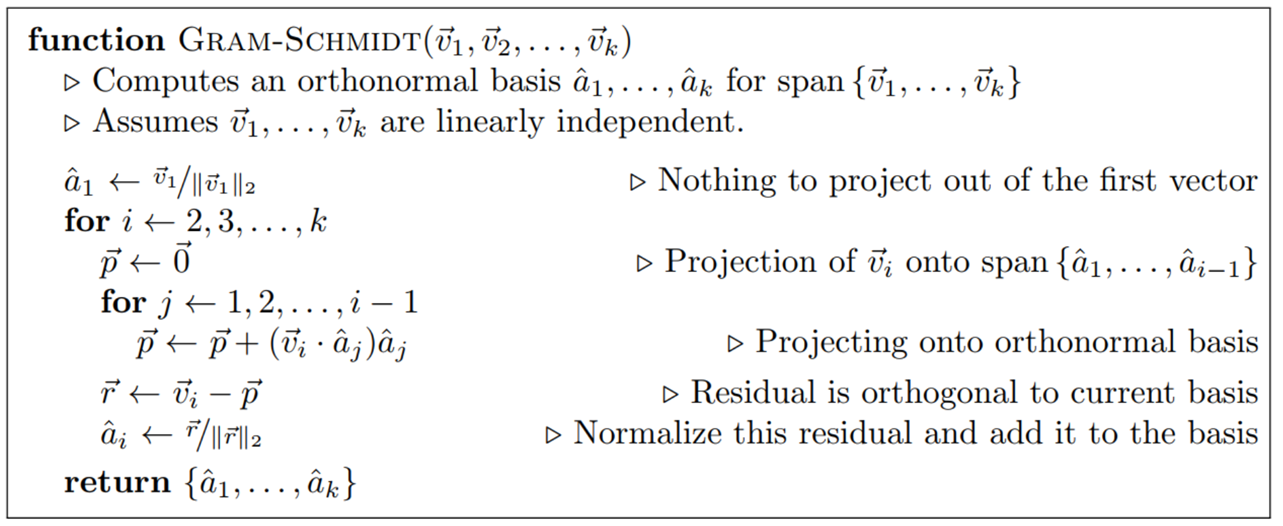
Gram-Schmidt 正交化是最自然的思路,每次取出一个向量并减去它到已经生成的子空间上的投影得到新的标准正交基。
每次计算投影向量都需要和 做内积,计算 过程中的误差会被逐步放大。比如 本身参与了 次运算,受到 误差影响的 参与了 次运算,依次类推,我们最终得到 大约叠加了 次有 误差参与的计算。 的误差分量可能在与 的运算过程中得到放大。
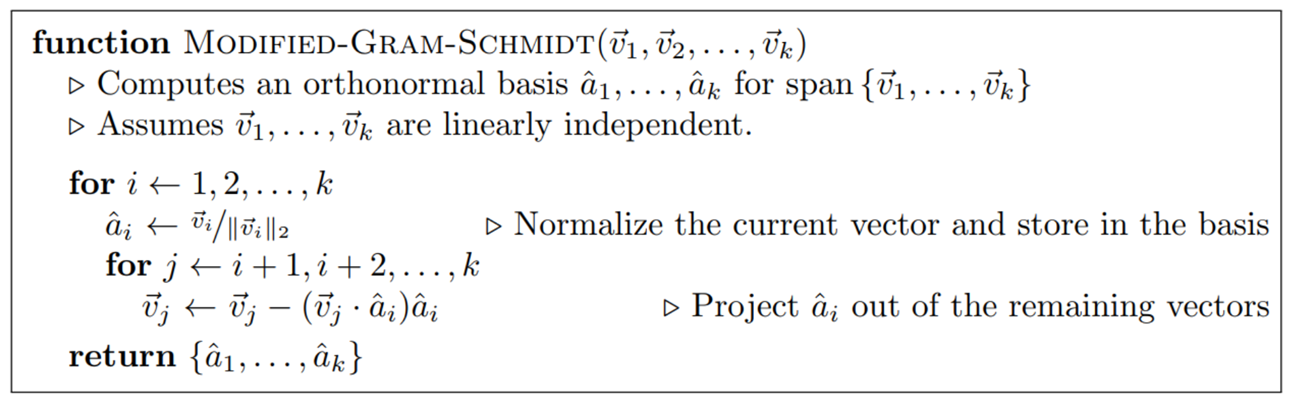
Modified Gram-Schmidt 正交化,从对每个 都计算子空间的投影到构建子空间时就直接剔除 的分量。得到的 取决于 , 受到 的影响,在 被 修正时, 已经失去了前 个基方向上的分量,在这些方向上不会放大 的误差
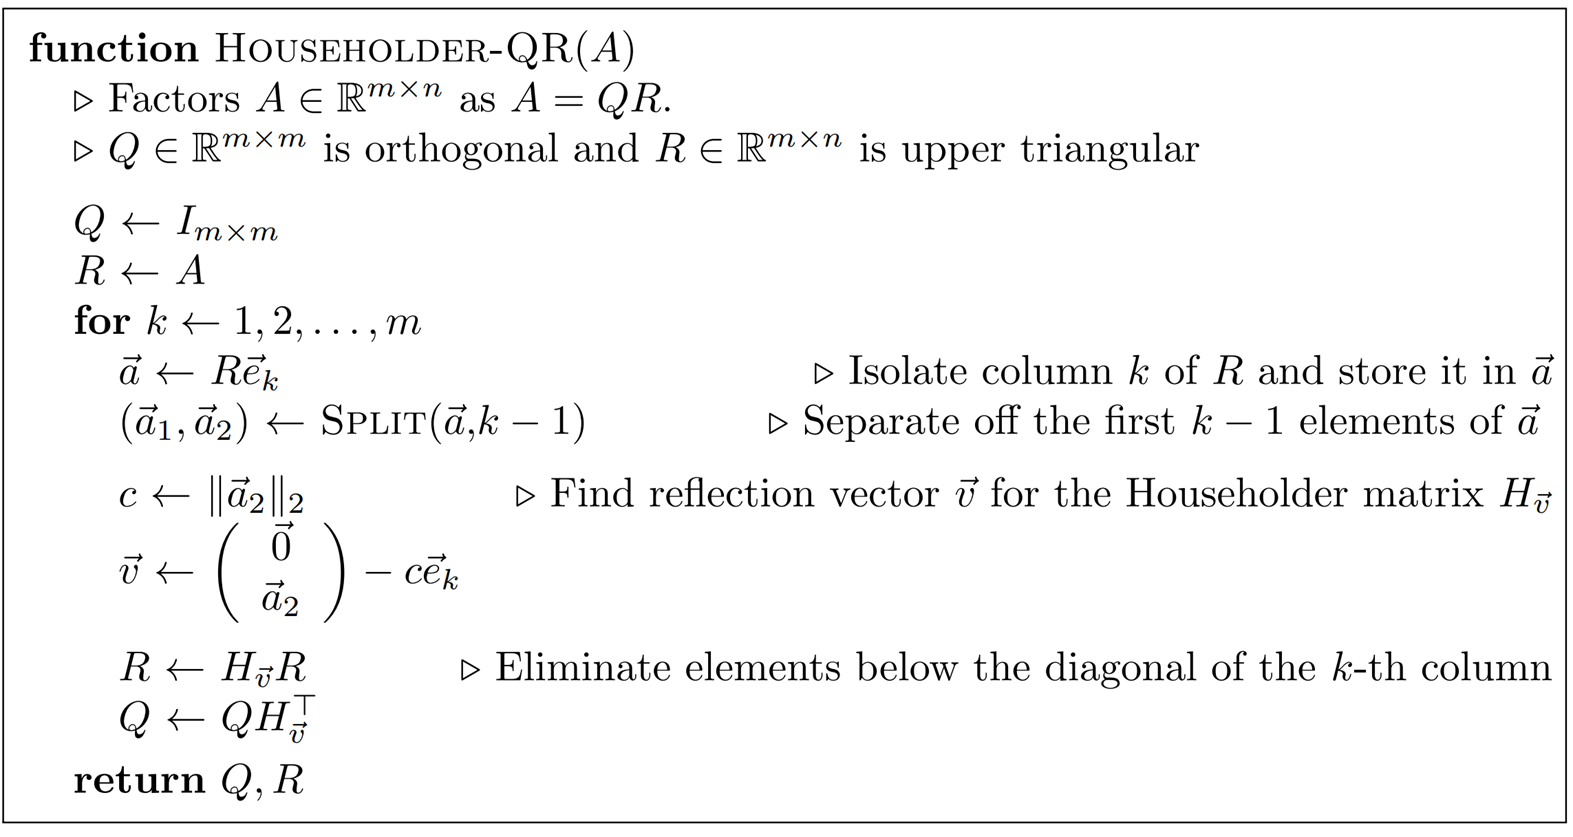
Householder QR
关于 轴对称向量为
关于镜面(法向量为 ,单位法向量为 )的镜像向量为
Eigen
Basics
可对角化的充要条件是其特征空间生成 。 内 可正交对角化的充要条件是 为实对称矩阵。
对角化能极大简化求逆
PCA
最小化垂直重构误差等价于最大化投影方差。
判断数据之间的相关性(PCA 主成分分析):
等价于
等价于求解 的主特征向量。求出的
主特征向量
采用迭代法 而不是解 然后解
Power iteration 使用迭代 求最大特征值。
Inverse iteration 使用迭代 求最小特征值,求逆用 代替。
Shifted
- 配合 Inverse iteration 求最接近于 的特征值
- 当 接近 时用 来替代,加速收敛
Rayleigh Quotient Iteration 把 作为 的逐轮最优估计值来加速迭代。
SVD
等价于
等价于求 的特征向量。
- 是对阵半正定矩阵,所以所有特征值都 并所有特征向量正交
- 的一组特征向量 和 的一组特定特征向量 可以通过 建立一一映射
- ,利用这一点归一化
- ,,我们可以自然地构造 ,如果 比较小,我们可以通过补全正交的零特征值特征向量得到 ,补全后 的列向量称为左奇异向量, 的对角线元素称为奇异值
Example: Overdetermined Equation and Pseudo Inverse
求解超定方程时施加 2-范数限制
限制条件等价于 ,令 转化为 ,取 那么有 ,其中 称为 的伪逆。
伪逆对于超定方程给出最小化 2-范数的解,对欠定方程给出在 2-范数意义下的最佳近似解。
Example: Low Rank Approximation
求 近似解时,可以舍弃较小 的谱;求 的近似解时可以舍弃较大 的谱
定理,用之秩至多为 的矩阵 来逼近 ,在 Frobenius 范数和谱范数的意义下,按照奇异值大小取前 大的谱作为 是所有谱组合中的的最优解
Proof?
Example: Least Square with Tikonov Regularization
Tikonov 正则化的最小二乘法 的解
Detail?
Example: Rigid Alignment
通过最小二乘处理
Orthogonal Procrustes Theorem:
- 保持 的形式分别需要 、
Detail?
Example: Eigenfaces(Minimum Reconstruction Error)
最小化 的取值是 的前 列,
Detail?
求根
二分法
- 根的存在性和算法收敛性:
- 充分条件: 且 ,则必定存在一个根 且二分法必定收敛。
- 一阶收敛速度
牛顿迭代法
- 收敛性:
- 局部收敛的充分条件:, 为单根(),必定存在一个 的 邻域,只要初始值在邻域内,牛顿迭代法必定收敛。
- 全局收敛的充分条件: 在 上单调、具有相同凹凸性,只要存在根(在此条件下等价于端点函数值异号),当 时牛顿迭代必定收敛。
- 不收敛的根本原因包括 局部性质差或者 的选择差。
- 收敛速度为 阶
切线法
- 收敛性
- 实际计算时在接近根时 会发生灾难性抵消,数值稳定性不好
- 收敛速度为 阶
- 记
- 用一阶商差和二阶商差(首尾相接的割线斜率的变化率)改写并利用商差中值定理
不动点迭代求不动点